CV d’ingénieur DevOps ou SRE : le guide et un exemple analysé
Sur un CV de DevOps ou de SRE, les outils se ressemblent tous : Kubernetes, Terraform, Prometheus reviennent dans chaque candidature. Ce qui départage deux profils, c’est le périmètre tenu (combien de services, d’environnements, d’équipes servies) et la manière dont tu mesures la fiabilité. Un responsable plateforme veut savoir ce qui a changé en production grâce à toi.
Cette page explique ce que regardent les équipes plateforme et SRE, la structure qui met en valeur un parcours venu de l’administration système, puis analyse section par section le modèle ci-dessus, que tu peux reprendre dans le générateur et ajuster à ton propre environnement.
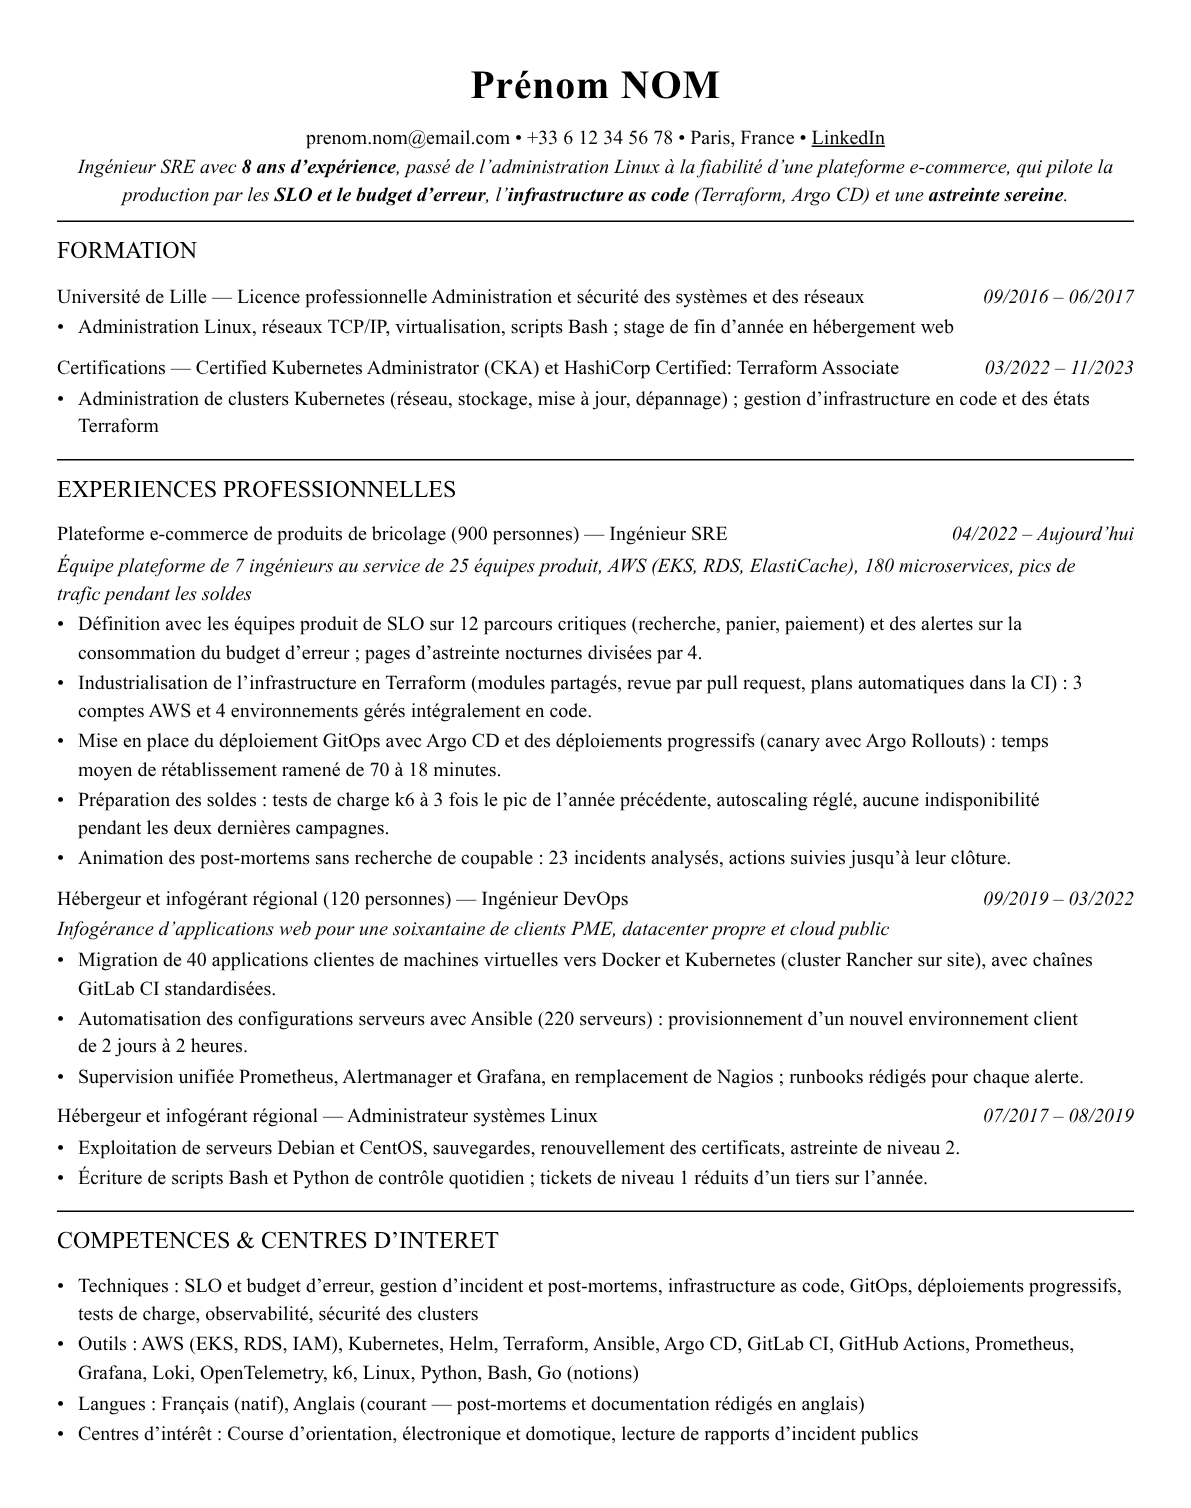
Ce CV est modifiable. Ouvre-le dans l’éditeur, remplace chaque ligne par ton parcours et exporte-le en PDF.
Ouvrir ce CV dans l’éditeurCe que les recruteurs attendent d’un CV ingénieur devops / sre
- Un périmètre chiffré : nombre de services, de clusters, de comptes cloud ou de serveurs, nombre d’équipes produit qui dépendent de ton travail.
- Une pratique de la fiabilité mesurée : SLO, budget d’erreur, temps moyen de rétablissement, fréquence des incidents. Pour un poste SRE, c’est le cœur du métier.
- L’infrastructure décrite en code et revue comme du code : modules Terraform, pull requests, plans automatiques, GitOps.
- Une astreinte et une gestion d’incident assumées : runbooks, post-mortems sans recherche de coupable, actions de suivi. Les recruteurs veulent savoir comment tu te comportes à trois heures du matin.
Le CV décortiqué, section par section
Chaque capture ci-dessous est extraite du CV ingénieur devops / sre présenté plus haut. Sous chacune : ce qui la rend efficace pour ce métier, et ce que tu dois y mettre de toi.
1. En-tête et accroche
Un parcours et une méthode de fiabilité en une phrase
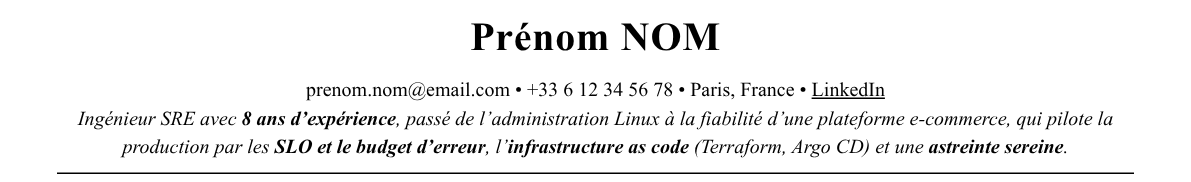
L’accroche fait deux choses à la fois : elle raconte la progression du candidat, de l’administration Linux à la fiabilité d’une plateforme, et elle nomme sa méthode. Les trois marqueurs choisis correspondent aux trois questions d’un responsable plateforme : comment tu mesures la fiabilité, comment tu gères l’infrastructure, comment tu vis la production. Rien n’y relève de l’adjectif.
Ce qui fonctionne
- « passé de l’administration Linux à la fiabilité d’une plateforme e-commerce » transforme un début de carrière souvent caché en socle technique assumé.
- « SLO et budget d’erreur » emploie le vocabulaire exact d’une offre SRE, que les expériences viennent ensuite démontrer.
- « une astreinte sereine » annonce un sujet que les recruteurs abordent toujours, avec une tonalité qui rassure.
À adapter à ton parcours : Remplace les trois marqueurs par ceux de ton quotidien réel et de l’offre : si tu n’as jamais défini de SLO, mets en avant la CI/CD ou l’infrastructure as code plutôt que d’emprunter le vocabulaire SRE.
2. Formation
Une licence professionnelle et deux certifications ciblées
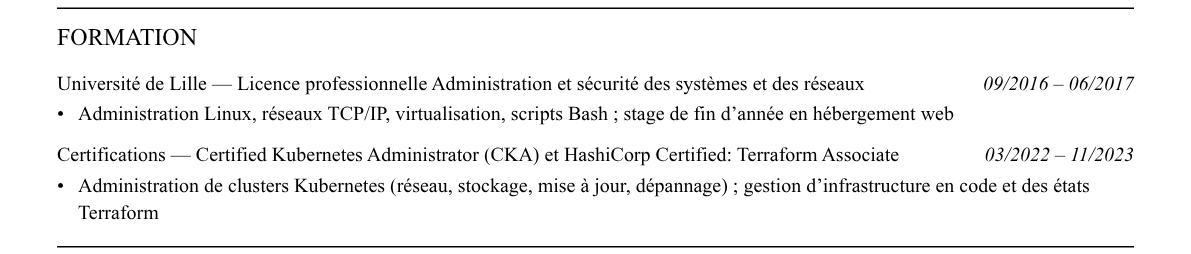
Le diplôme, une licence professionnelle d’administration système, est court et assumé. Les deux certifications, passées en cours de carrière, couvrent exactement les deux piliers du poste visé : l’exploitation de Kubernetes et l’infrastructure en code. Pour un profil sans diplôme d’ingénieur, ce couple formation courte et certifications récentes rassure sur la mise à niveau continue.
Ce qui fonctionne
- « Administration Linux, réseaux TCP/IP, virtualisation, scripts Bash » rappelle les fondamentaux que tous les entretiens SRE vérifient.
- « Certified Kubernetes Administrator (CKA) » est une certification pratique, passée sur un terminal, que les équipes plateforme connaissent bien.
- « HashiCorp Certified: Terraform Associate » s’accorde avec la puce d’industrialisation Terraform de l’expérience actuelle.
À adapter à ton parcours : Ne garde que les certifications qui correspondent à l’offre et indique leur date ; une certification ancienne sur un outil abandonné n’apporte plus rien.
3. Expériences
Une production décrite par ses indicateurs
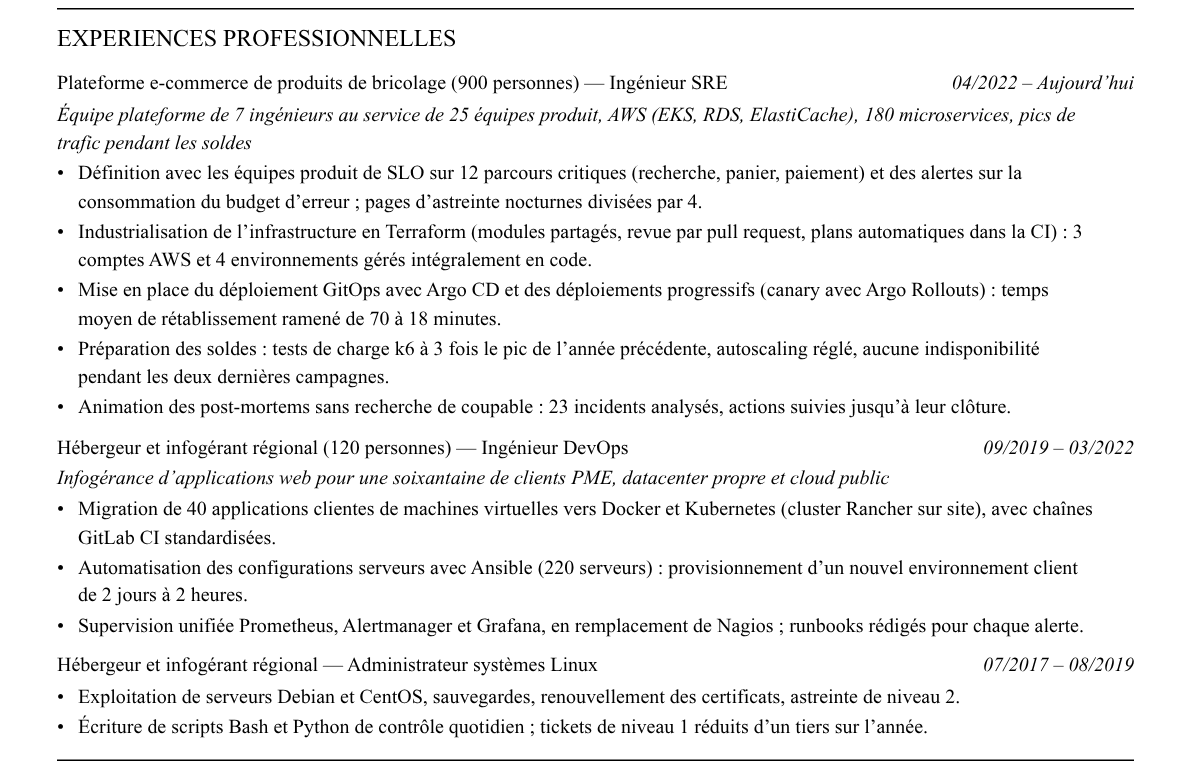
Chaque poste commence par une ligne de contexte qui donne la mesure du périmètre : équipe plateforme de 7 ingénieurs, 25 équipes produit servies, 180 microservices, pics de trafic des soldes. Les puces associent ensuite une pratique à un indicateur d’exploitation, ce qui permet au recruteur de juger l’impact réel. La progression de l’hébergeur à la plateforme e-commerce est lisible sans commentaire.
Ce qui fonctionne
- « SLO sur 12 parcours critiques » et « pages d’astreinte nocturnes divisées par 4 » relient la méthode SRE à un effet concret sur l’équipe.
- « temps moyen de rétablissement ramené de 70 à 18 minutes » donne un indicateur classique de fiabilité, avec la technique qui l’explique (Argo CD, canary).
- « 23 incidents analysés, actions suivies jusqu’à leur clôture » prouve une culture du post-mortem, que beaucoup de CV oublient.
À adapter à ton parcours : Commence chaque poste par ton périmètre réel (services, environnements, équipes servies) et garde au moins une puce avant / après sur un indicateur que tu suivais vraiment.
4. Compétences et centres d’intérêt
Pratiques d’abord, outils regroupés par usage
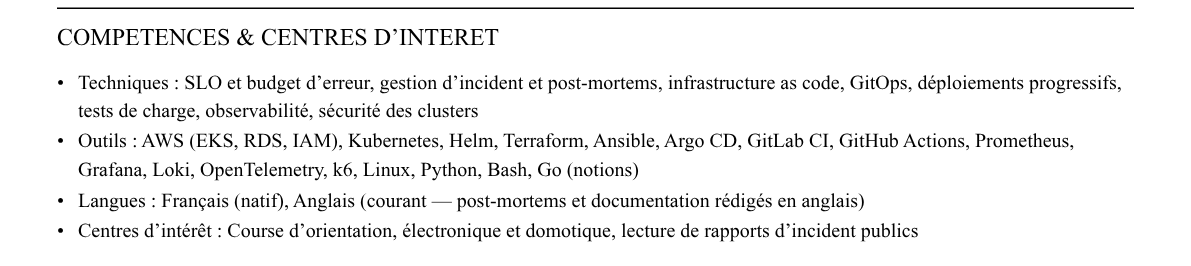
Le bloc sépare les pratiques des outils, et les pratiques viennent en premier : c’est ce qu’un responsable SRE cherche avant de vérifier la chaîne technique. Les outils couvrent une chaîne complète, du cloud à l’observabilité, sans doublons inutiles. La mention « Go (notions) » montre une honnêteté sur le niveau qui crédibilise le reste de la liste.
Ce qui fonctionne
- « SLO et budget d’erreur, gestion d’incident et post-mortems » place les savoir-faire de fiabilité au même niveau que les technologies.
- « Prometheus, Grafana, Loki, OpenTelemetry » décrit une observabilité complète : métriques, journaux et traces.
- « post-mortems et documentation rédigés en anglais » rattache la langue à un usage précis du métier.
À adapter à ton parcours : Range tes outils par usage (cloud, conteneurs, infrastructure, observabilité, scripts) et signale franchement ceux que tu ne pratiques qu’en notions.
La structure en résumé
- En-tête : Intitulé exact (DevOps, SRE, ingénieur plateforme), années d’expérience, cloud principal et deux marqueurs de ton approche : SLO, GitOps, infrastructure as code, astreinte.
- Expériences : En premier. Chaque poste commence par le contexte d’exploitation (cloud, nombre de services, équipes servies, contraintes de trafic), puis des puces qui associent une action à un effet sur la production.
- Formation et certifications : Diplôme en une ligne, puis les certifications qui ont un sens pour le poste (CKA, Terraform Associate, certification d’un fournisseur cloud), avec leur date.
- Compétences : Deux lignes : les pratiques (SLO, gestion d’incident, GitOps, tests de charge) puis les outils, regroupés par usage pour que le recruteur reconnaisse ta chaîne complète.
- Langues et intérêts : Précise si tu rédiges tes post-mortems ou ta documentation en anglais : c’est fréquent dans les équipes plateforme et souvent demandé.
Compétences et mots-clés ATS
- Kubernetes en production, managé (EKS, GKE, AKS) ou sur site, avec Helm et une approche GitOps (Argo CD, Flux)
- Infrastructure as code avec Terraform et gestion de configuration avec Ansible, revues par pull request
- Observabilité : métriques, journaux et traces (Prometheus, Grafana, Loki, OpenTelemetry), alertes reliées à des SLO
- Gestion d’incident, astreinte, runbooks et post-mortems sans recherche de coupable
- Scripts et outillage en Python, Bash ou Go, tests de charge (k6) et préparation des pics de trafic
Les logiciels de tri (ATS) recherchent les termes exacts de l’offre. Pour un poste en ingénieur devops / sre, intègre naturellement :
Les erreurs à éviter
- Aligner trente outils sans dire ce qu’ils faisaient tourner : « Kubernetes, Docker, Terraform, Ansible, Jenkins » ne dit rien du nombre de services ni de ton rôle.
- Confondre DevOps et SRE dans l’accroche : si l’offre parle de SLO et de budget d’erreur, montre que tu les as définis, pas seulement que tu as maintenu une CI.
- Ne jamais parler d’incident : un ingénieur de production sans post-mortem sur son CV laisse penser qu’il n’a pas été en première ligne.
- Cacher un parcours d’administrateur système : il explique ta solidité sur Linux et le réseau, que les entretiens vérifient presque toujours.
Le conseil TechCV : Ajoute à chaque poste une puce « avant / après » sur un indicateur d’exploitation : délai de mise en production, temps de rétablissement, pages d’astreinte, durée de provisionnement. Un responsable plateforme la lira en premier, et elle te donne une histoire précise à raconter en entretien, avec ce qui n’a pas marché au passage.
Questions fréquentes
Quelle différence faire entre DevOps et SRE sur un CV ?
Le DevOps met l’accent sur l’outillage de livraison (CI/CD, environnements, infrastructure as code), le SRE sur la fiabilité mesurée (SLO, budget d’erreur, gestion d’incident). Choisis l’intitulé de l’offre et mets en avant les puces qui correspondent à ce versant.
Les certifications Kubernetes et Terraform comptent-elles ?
Elles aident à passer le premier tri et rassurent sur un profil venu de l’administration système. Elles ne remplacent pas un périmètre de production décrit précisément. Place-les sous la formation, avec leur date.
Comment parler d’astreinte sans avoir l’air de se plaindre ?
En la décrivant comme une responsabilité et un sujet d’amélioration : rythme, périmètre, et ce que tu as fait pour la rendre plus calme (alertes mieux réglées, runbooks, automatisation). C’est exactement ce qu’une équipe SRE cherche.
Pour aller plus loin
- Kubernetes sur un CV : utilisé, déployé ou conçu, il faut le dire
- Infrastructure as code sur un CV : un périmètre plutôt que des outils
- Quelle certification AWS, Azure ou GCP pour un premier poste cloud ?
Partez de ce CV ingénieur devops / sre
Même structure, mêmes rubriques, prêtes à personnaliser. Export PDF d’une page.