CV de data engineer : le guide et un exemple analysé
Un CV de data engineer se lit très différemment d’un CV de data scientist, même si les deux citent Python et SQL. On n’y cherche pas des modèles et des scores, mais des flux : d’où vient la donnée, combien en passe chaque jour, en combien de temps elle est disponible, et comment on sait qu’elle est juste. Le recruteur veut reconnaître quelqu’un qui construit et maintient la tuyauterie dont tout le reste dépend.
Cette page détaille ce que regardent les responsables de plateformes data, la structure de CV qui met en avant les volumes, la fiabilité et les coûts, puis analyse section par section le modèle ci-dessus, que tu peux reprendre dans le générateur.
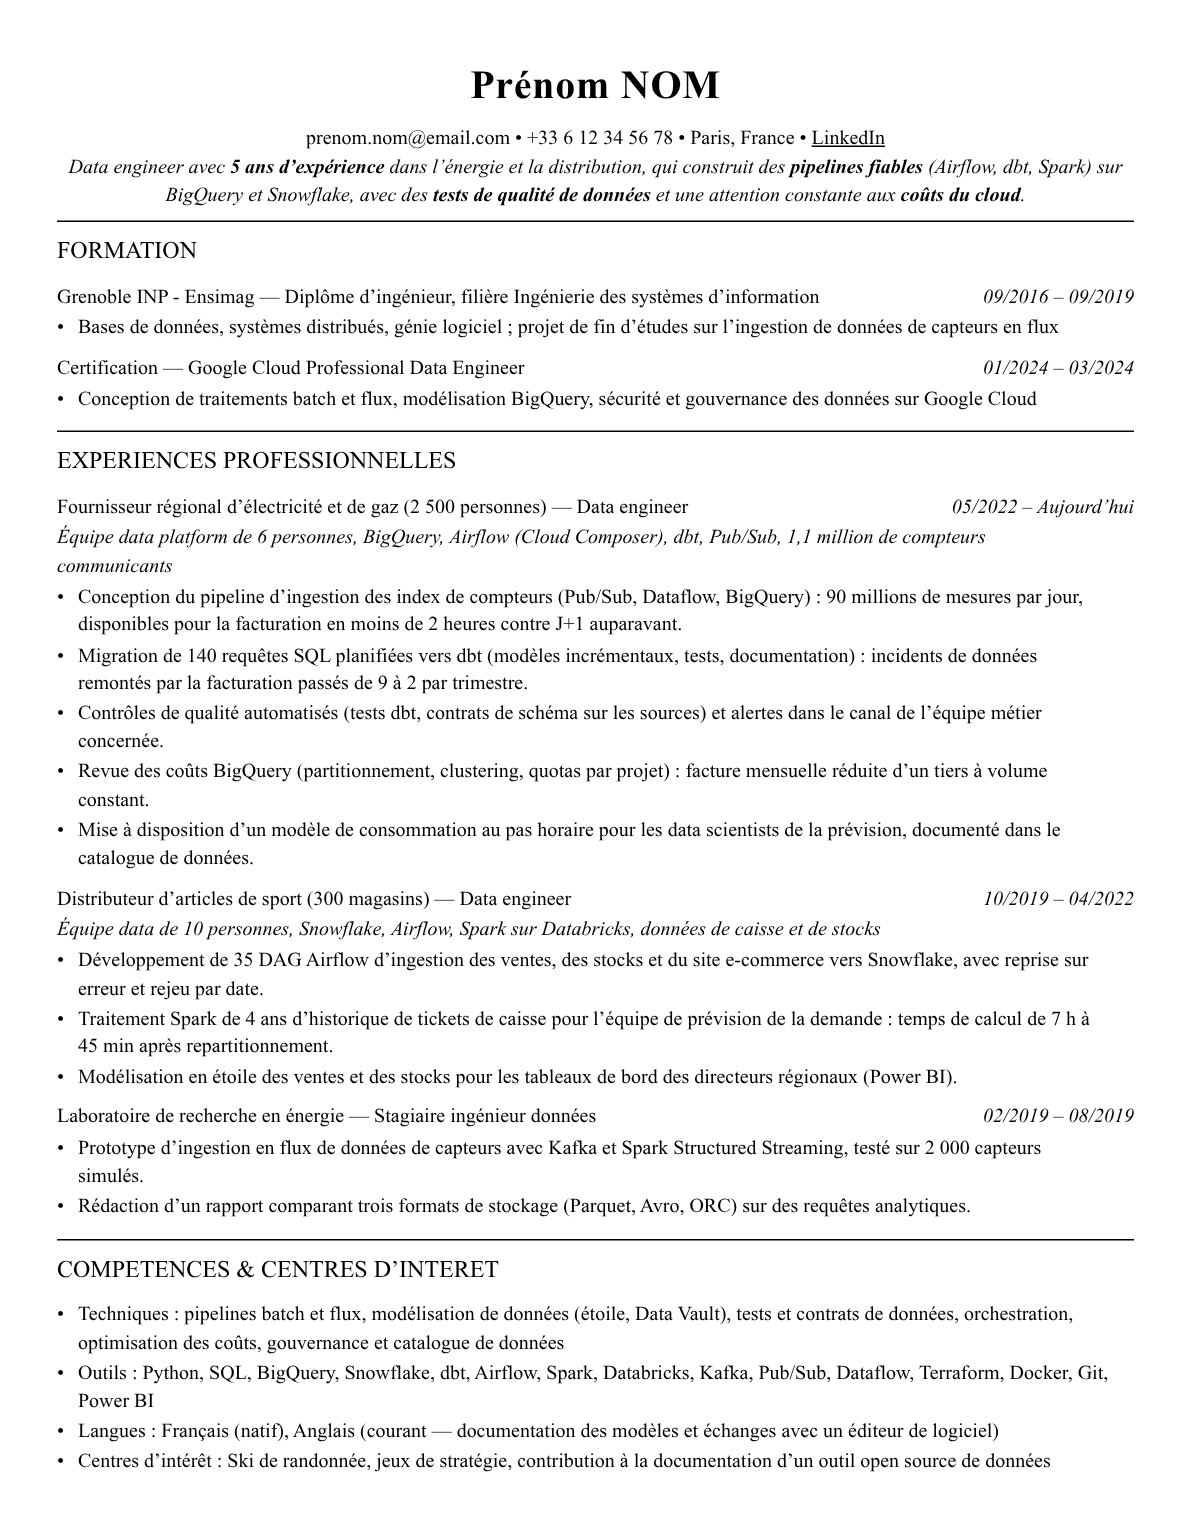
Ce CV est modifiable. Ouvre-le dans l’éditeur, remplace chaque ligne par ton parcours et exporte-le en PDF.
Ouvrir ce CV dans l’éditeurCe que les recruteurs attendent d’un CV data engineer
- Des pipelines décrits par leurs volumes et leurs délais : nombre d’événements par jour, fraîcheur de la donnée, fenêtre de traitement.
- La qualité des données traitée comme un livrable : tests, contrats de schéma, alertes, baisse des incidents remontés par les utilisateurs.
- Une maîtrise de l’entrepôt et de la modélisation : BigQuery, Snowflake ou Databricks, modèles en étoile, transformations versionnées avec dbt.
- Une attention aux coûts du cloud : partitionnement, quotas, requêtes optimisées. Les équipes data sont de plus en plus jugées sur leur facture.
Le CV décortiqué, section par section
Chaque capture ci-dessous est extraite du CV data engineer présenté plus haut. Sous chacune : ce qui la rend efficace pour ce métier, et ce que tu dois y mettre de toi.
1. En-tête et accroche
Des pipelines, pas des modèles
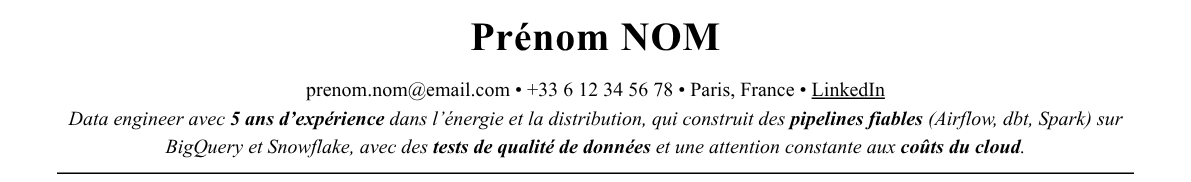
L’accroche positionne le candidat du côté de la tuyauterie : elle parle de pipelines, de qualité et de coûts, jamais d’algorithmes. Ce choix évite la confusion fréquente avec un data scientist, alors que les deux profils partagent Python et SQL. Elle cite aussi les secteurs, ce qui aide un recruteur de l’énergie ou du commerce à se projeter.
Ce qui fonctionne
- « construit des pipelines fiables (Airflow, dbt, Spark) » nomme le métier et ses outils principaux dans la même phrase.
- « sur BigQuery et Snowflake » cite deux entrepôts réellement utilisés, ce qui élargit les offres compatibles sans tomber dans l’inventaire.
- « une attention constante aux coûts du cloud » met en avant un critère que les responsables de plateformes data surveillent de près.
À adapter à ton parcours : Cite les briques que tu utilises vraiment chaque semaine et le secteur de tes données ; si tu viens de la data science, assume la transition plutôt que de garder un vocabulaire de modélisation.
2. Formation
Une école d’ingénieurs et une certification orientée données
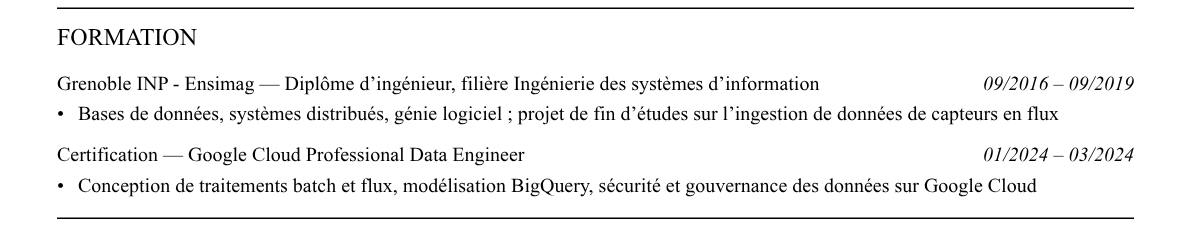
La formation est courte mais parfaitement alignée : une filière systèmes d’information, un projet de fin d’études sur les données en flux, puis une certification de fournisseur cloud consacrée à l’ingénierie des données. Le recruteur y lit une continuité entre les études et le métier exercé, ce qui renforce le positionnement de l’accroche.
Ce qui fonctionne
- « Bases de données, systèmes distribués, génie logiciel » résume les trois piliers du métier de data engineer.
- « projet de fin d’études sur l’ingestion de données de capteurs en flux » annonce l’expérience actuelle sur les compteurs communicants.
- « Google Cloud Professional Data Engineer » correspond exactement à la plateforme du poste actuel (BigQuery, Pub/Sub, Dataflow).
À adapter à ton parcours : Choisis une certification seulement si elle correspond au cloud de l’offre, et rattache ton projet d’études à ton métier actuel par une formulation précise.
3. Expériences
Volumes, délais, qualité et coûts dans chaque puce
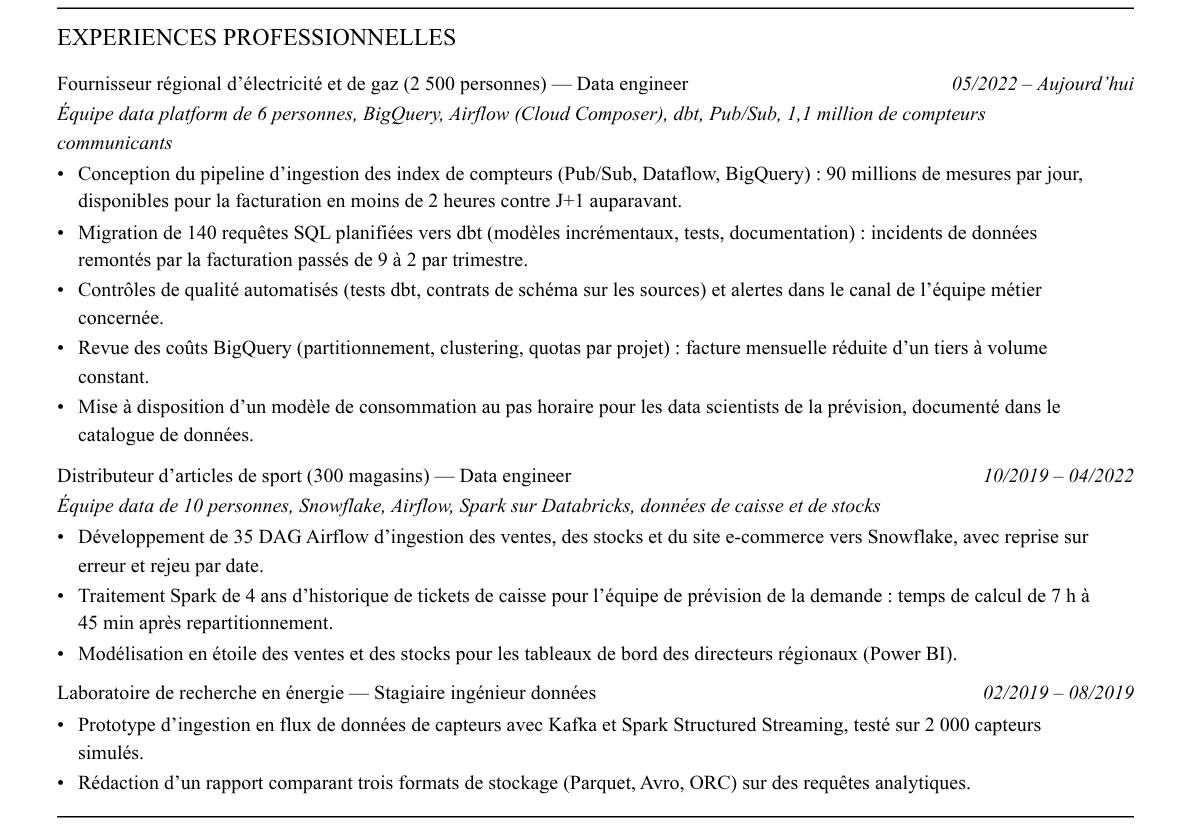
Chaque pipeline est décrit par ce qu’un responsable data veut savoir : d’où vient la donnée, combien en passe, en combien de temps elle est prête et pour qui. Les puces sur la qualité et les coûts transforment des sujets souvent invisibles en résultats. Le poste chez le distributeur montre la même logique sur un autre entrepôt et d’autres données, ce qui prouve que la méthode n’est pas liée à un outil.
Ce qui fonctionne
- « 90 millions de mesures par jour, disponibles pour la facturation en moins de 2 heures contre J+1 » donne le volume, le délai et l’utilisateur en une phrase.
- « incidents de données remontés par la facturation passés de 9 à 2 par trimestre » mesure la qualité du point de vue des équipes qui consomment la donnée.
- « temps de calcul de 7 h à 45 min après repartitionnement » relie une technique Spark précise à un gain concret pour l’équipe de prévision.
À adapter à ton parcours : Pour ton pipeline principal, écris la puce volume, délai, utilisateurs ; ajoute ensuite une puce sur la qualité et une sur les coûts, même si les gains sont modestes.
4. Compétences et centres d’intérêt
Une chaîne cohérente de l’ingestion à la gouvernance
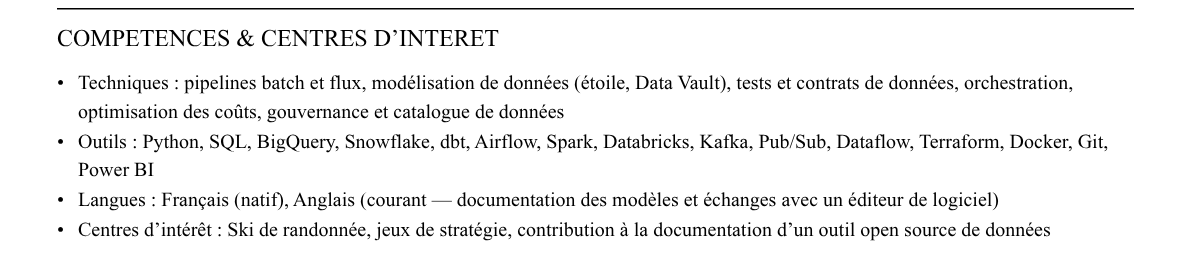
Le bloc final décrit une chaîne complète : ingestion, orchestration, transformation, entrepôt, gouvernance. Les savoir-faire viennent avant les outils, et la modélisation est précisée (étoile, Data Vault), ce qui évite le flou habituel du mot « modélisation ». La contribution à la documentation d’un outil open source, mentionnée dans les intérêts, ajoute un signal discret mais vérifiable.
Ce qui fonctionne
- « tests et contrats de données » montre que la qualité est traitée comme une compétence, pas comme une intention.
- « Terraform, Docker » rappelle que le candidat sait déployer sa plateforme, ce qui le distingue d’un profil purement analytique.
- « contribution à la documentation d’un outil open source de données » ouvre une conversation d’entretien sans prétendre à plus qu’elle n’est.
À adapter à ton parcours : Garde une chaîne que tu sais expliquer de bout en bout et précise le type de modélisation que tu pratiques ; retire les outils que tu n’as vus qu’en formation.
La structure en résumé
- En-tête : Intitulé « Data engineer », années d’expérience, secteurs, puis les briques principales (orchestration, transformation, entrepôt) et ce que tu garantis : fiabilité, qualité, coûts.
- Expériences : Chaque poste avec une ligne de contexte (équipe, entrepôt, outils, nature des données), puis des puces qui relient un pipeline à son volume, son délai et ses utilisateurs.
- Formation et certification : École ou université en une ligne, avec un projet lié aux données si tu en as un, puis une certification de fournisseur cloud orientée données si elle correspond à l’offre.
- Compétences : Les savoir-faire (batch, flux, modélisation, tests de données, gouvernance) d’abord, les outils ensuite, en gardant ceux que tu utilises toutes les semaines.
- Langues et intérêts : Une ligne chacun ; une contribution à un outil open source de données mérite d’être citée, même modeste.
Compétences et mots-clés ATS
- Orchestration et transformation : Airflow, dbt, modèles incrémentaux et rejeu par date
- Entrepôts et lacs de données : BigQuery, Snowflake, Databricks, formats Parquet et Avro
- Traitements distribués et flux : Spark, Kafka ou Pub/Sub, Dataflow ou Spark Structured Streaming
- Qualité et gouvernance : tests de données, contrats de schéma, catalogue, documentation des modèles
- SQL avancé et Python, avec Terraform et Docker pour déployer la plateforme
Les logiciels de tri (ATS) recherchent les termes exacts de l’offre. Pour un poste en data engineer, intègre naturellement :
Les erreurs à éviter
- Écrire un CV de data scientist par habitude : parler d’algorithmes et de précision alors que l’offre attend des pipelines, des volumes et des délais.
- Citer « Big Data » sans aucune taille : sans ordre de grandeur, le recruteur ne sait pas si tu as manipulé quelques fichiers ou des milliards de lignes.
- Oublier les utilisateurs de tes données : facturation, prévision, tableaux de bord ; c’est ce qui donne du sens à un pipeline sur le papier.
- Mettre toutes les briques du marché dans les compétences : un responsable plateforme préfère une chaîne cohérente, que tu sais expliquer de bout en bout.
Le conseil TechCV : Pour ton pipeline principal, écris une seule puce qui répond à quatre questions : d’où vient la donnée, combien en passe, en combien de temps elle est prête, pour qui. Si tu peux ajouter comment tu sais qu’elle est juste, tu as la puce que les équipes data cherchent et la base de ta réponse en entretien de conception.
Questions fréquentes
Quelle différence entre un CV de data engineer et un CV de data scientist ?
Le data scientist met en avant des modèles, des expériences et leur effet métier ; le data engineer met en avant des flux, des volumes, des délais et la qualité des données livrées. Les outils se recoupent, mais les puces ne racontent pas la même chose.
Faut-il une certification cloud pour être data engineer ?
Non, mais une certification orientée données d’un fournisseur cloud aide quand l’offre cite ce fournisseur. Elle ne remplace pas un pipeline en production décrit avec ses volumes.
Comment montrer la qualité des données sur un CV ?
Par un mécanisme et un effet : tests dbt, contrats de schéma ou alertes, et la baisse des incidents signalés par les équipes qui consomment la donnée. Le mot « qualité » seul ne dit rien.
Pour aller plus loin
- Data engineer : un métier entre logiciel et données
- Quel niveau de SQL annoncer sur un CV de data ?
- Data analyst ou data scientist, deux métiers qu'on confond souvent
Partez de ce CV data engineer
Même structure, mêmes rubriques, prêtes à personnaliser. Export PDF d’une page.