CV d’ingénieur machine learning : le guide et un exemple analysé
Un ingénieur machine learning est recruté pour ce qui se passe après le notebook : servir un modèle avec une latence tenue, le réentraîner sans tout refaire à la main, s’apercevoir qu’il se dégrade avant que les clients ne le signalent. Un CV qui ne parle que d’architectures de réseaux et de scores de validation se lit comme celui d’un data scientist, même avec le bon intitulé.
Cette page détaille ce que cherchent les équipes qui industrialisent le machine learning, la structure qui met en avant la mise en production, puis analyse section par section le modèle ci-dessus : un parcours passé de la data science au MLOps, que tu peux reprendre dans le générateur.
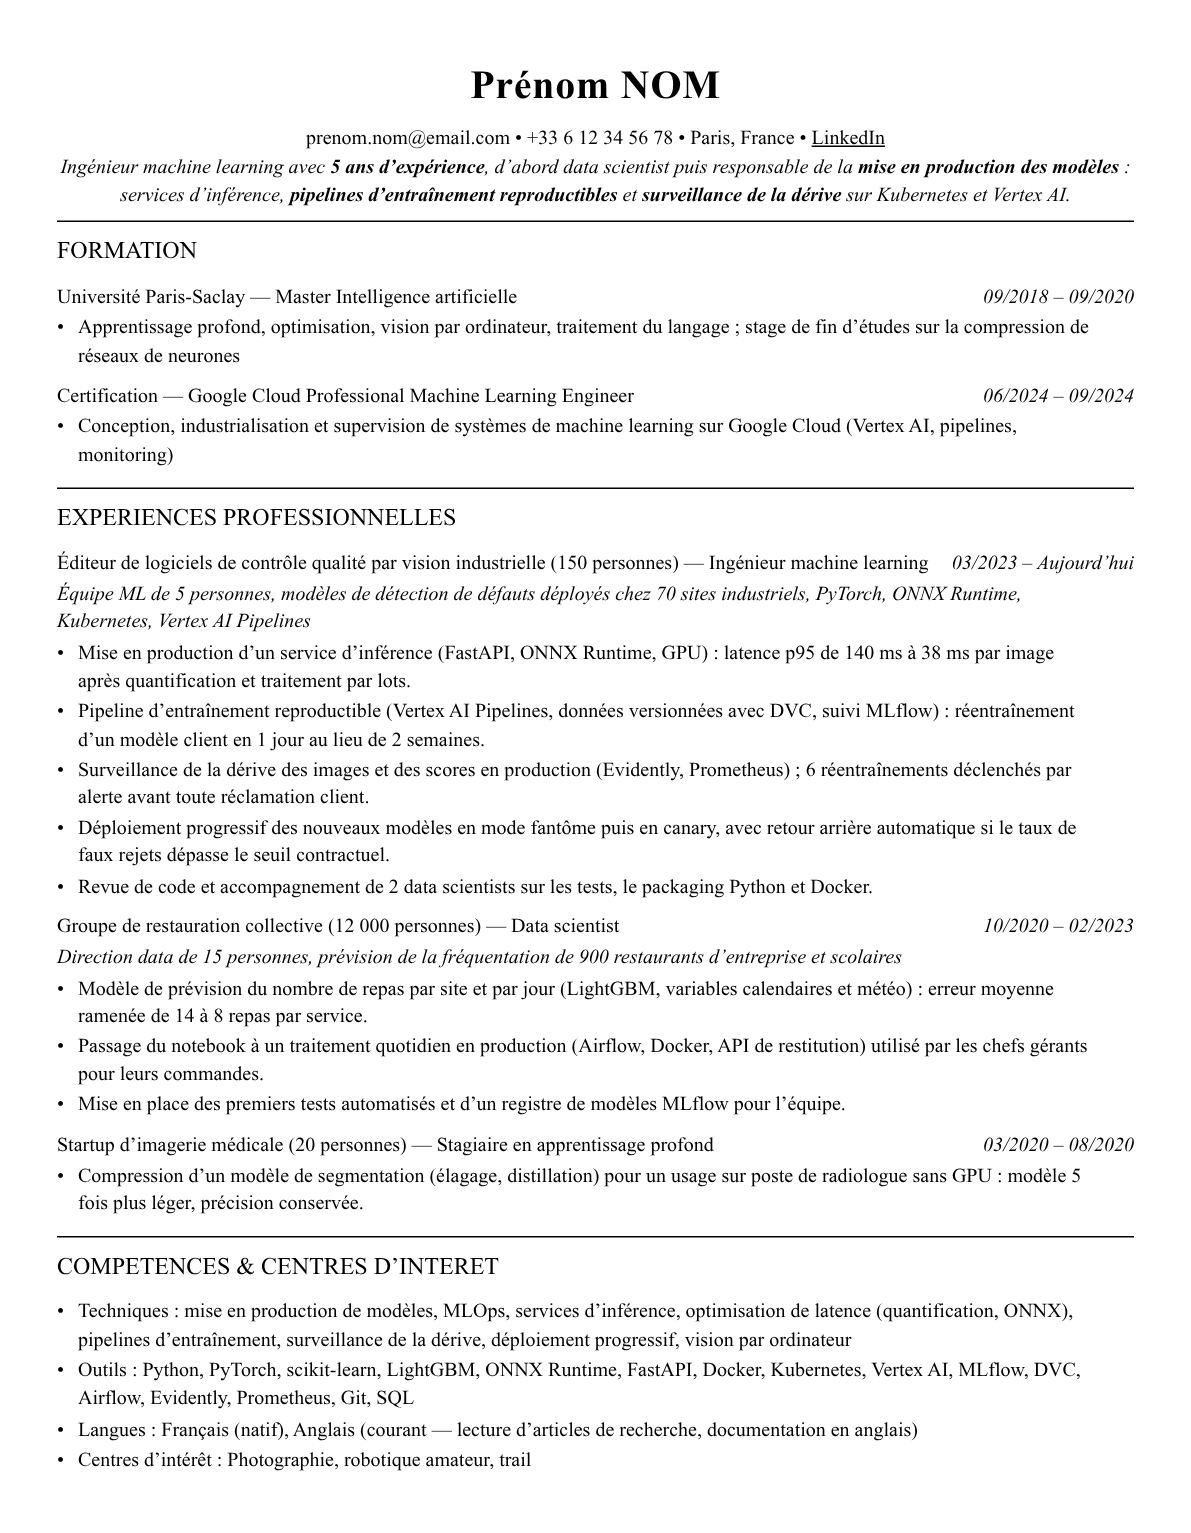
Ce CV est modifiable. Ouvre-le dans l’éditeur, remplace chaque ligne par ton parcours et exporte-le en PDF.
Ouvrir ce CV dans l’éditeurCe que les recruteurs attendent d’un CV ingénieur machine learning
- Des modèles en production, décrits par leur service : latence, débit, matériel, nombre de clients ou d’utilisateurs servis.
- Des pipelines d’entraînement reproductibles : données et modèles versionnés, suivi des expériences, réentraînement déclenchable.
- Une surveillance réelle après le déploiement : dérive des données, dérive des scores, alertes et procédure de retour arrière.
- Un niveau d’ingénieur logiciel : tests, packaging, conteneurs, revue de code. C’est souvent le critère qui écarte les profils trop orientés recherche.
Le CV décortiqué, section par section
Chaque capture ci-dessous est extraite du CV ingénieur machine learning présenté plus haut. Sous chacune : ce qui la rend efficace pour ce métier, et ce que tu dois y mettre de toi.
1. En-tête et accroche
Le passage de la data science à la production
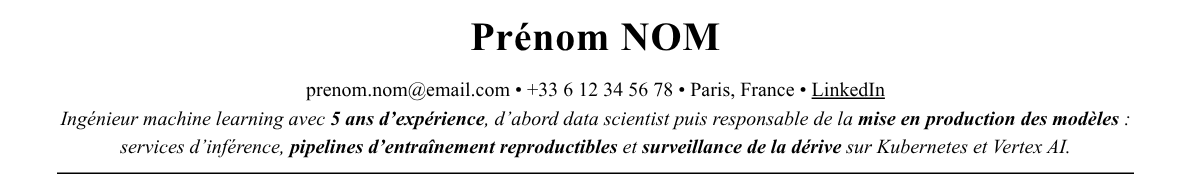
L’accroche assume la trajectoire, de data scientist à ingénieur ML, et la résume par ce qui a changé : la responsabilité des modèles une fois déployés. Les trois marqueurs choisis couvrent le cycle de vie complet, du service d’inférence au réentraînement et à la surveillance. Un recruteur comprend immédiatement que le candidat ne s’arrête pas au notebook.
Ce qui fonctionne
- « d’abord data scientist puis responsable de la mise en production des modèles » explique la trajectoire en une proposition, sans rupture apparente.
- « pipelines d’entraînement reproductibles » vise un problème très concret des équipes ML, que l’expérience actuelle chiffre ensuite.
- « sur Kubernetes et Vertex AI » nomme l’environnement technique, ce qui permet un tri rapide par rapport à l’offre.
À adapter à ton parcours : Résume ta trajectoire en une proposition et choisis trois marqueurs que tu peux prouver plus bas ; si tu n’as jamais surveillé de modèle en production, n’en parle pas encore.
2. Formation
Un master d’IA relié à un sujet de production
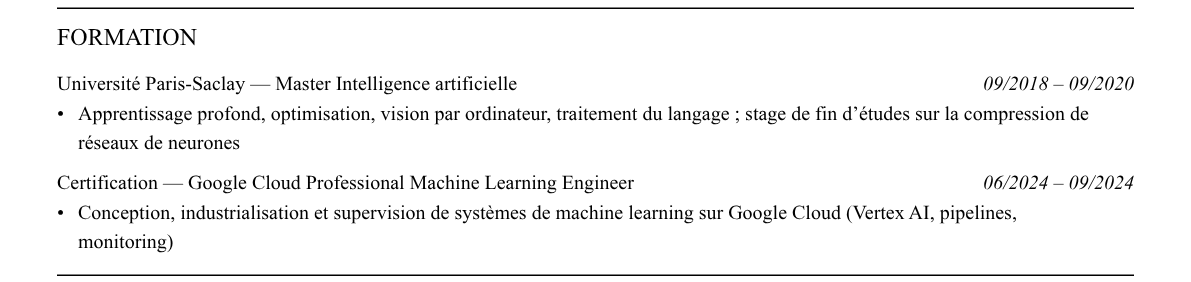
Le master est présenté avec des matières utiles et un sujet de stage sur la compression de réseaux de neurones, qui annonce le goût du candidat pour l’optimisation et le déploiement. La certification, plus récente, confirme le virage vers l’industrialisation sur la plateforme utilisée au quotidien. L’ensemble évite le piège d’une formation qui ferait lire le profil comme celui d’un chercheur.
Ce qui fonctionne
- « Apprentissage profond, optimisation, vision par ordinateur » s’accorde avec le domaine de l’expérience actuelle.
- « stage de fin d’études sur la compression de réseaux de neurones » prépare la lecture de la puce sur la quantification et la latence.
- « Google Cloud Professional Machine Learning Engineer » correspond à l’outillage du poste actuel (Vertex AI, pipelines, monitoring).
À adapter à ton parcours : Garde le sujet de stage ou de mémoire s’il touche à l’optimisation ou au déploiement ; sinon, une ligne de matières suffit.
3. Expériences
Des modèles décrits comme des services
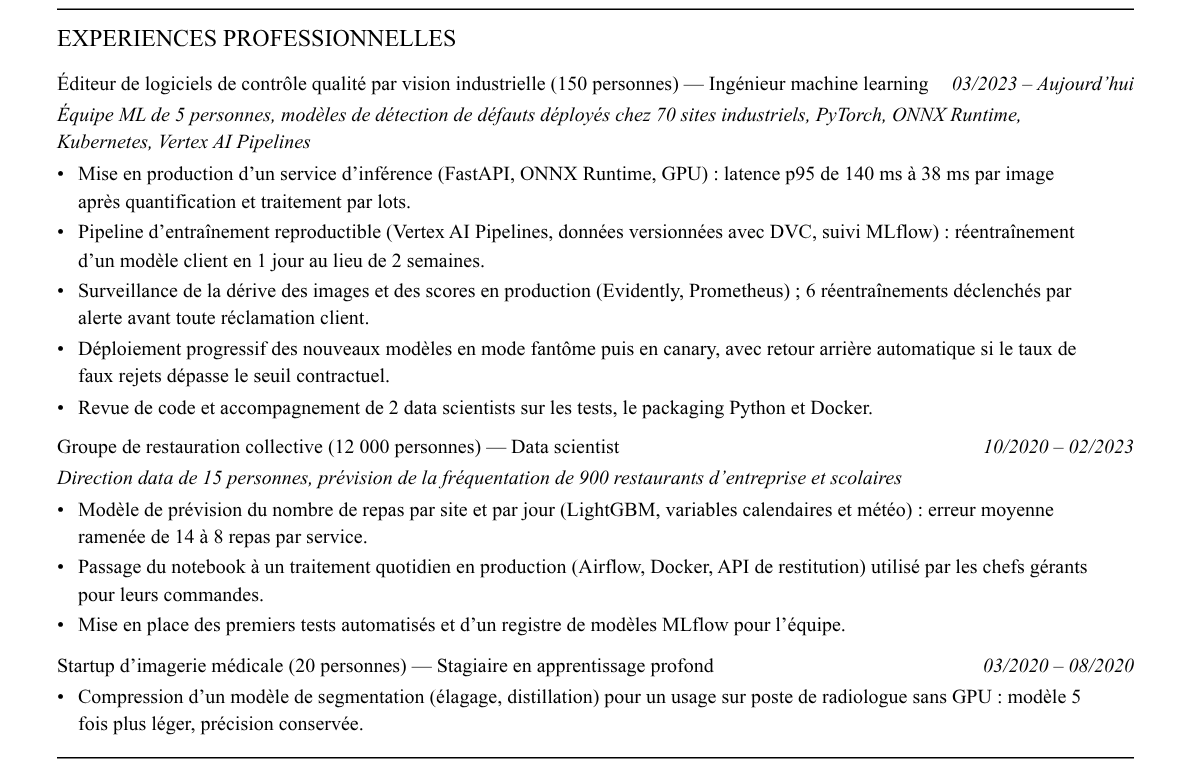
Les puces de l’expérience actuelle racontent la vie d’un modèle après l’entraînement : latence du service, temps de réentraînement, surveillance de la dérive, déploiement progressif avec retour arrière. Le poste précédent montre la transition, avec le passage d’un notebook à un traitement quotidien utilisé par des équipes de terrain. C’est exactement le récit qu’un responsable MLOps veut entendre.
Ce qui fonctionne
- « latence p95 de 140 ms à 38 ms par image après quantification et traitement par lots » donne la métrique, la valeur et la technique.
- « réentraînement d’un modèle client en 1 jour au lieu de 2 semaines » chiffre l’effet de la reproductibilité sur l’activité de l’éditeur.
- « 6 réentraînements déclenchés par alerte avant toute réclamation client » prouve une surveillance qui fonctionne réellement en production.
À adapter à ton parcours : Pour chaque modèle en production, écris qui l’appelle, en combien de temps il répond et comment tu sais qu’il se dégrade ; garde l’algorithme pour l’entretien.
4. Compétences et centres d’intérêt
Pratiques MLOps et outillage de production
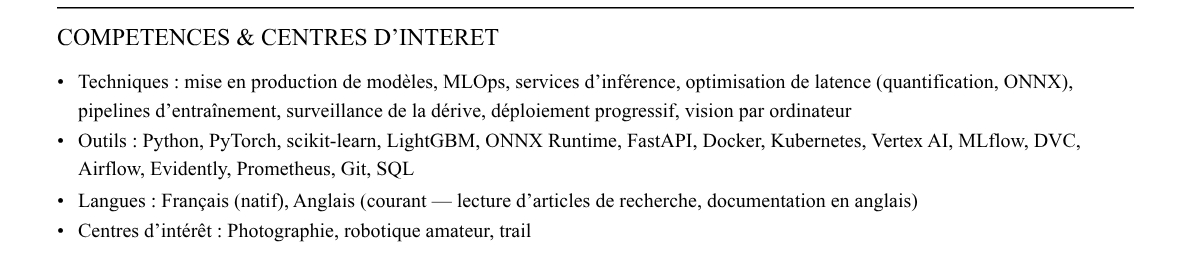
Le bloc commence par les pratiques (mise en production, surveillance, déploiement progressif) avant les bibliothèques. La liste d’outils reste resserrée et cohérente : une bibliothèque d’apprentissage profond, un moteur d’inférence, un framework d’API, l’orchestration et le suivi. Elle évite l’empilement de modèles et de frameworks que l’on trouve sur beaucoup de CV de data.
Ce qui fonctionne
- « optimisation de latence (quantification, ONNX) » précise une compétence que peu de candidats savent démontrer.
- « MLflow, DVC, Airflow, Evidently, Prometheus » couvre suivi, versionnement, orchestration et surveillance sans redondance.
- « accompagnement de 2 data scientists sur les tests, le packaging Python et Docker » confirme un niveau d’ingénieur logiciel reconnu par l’équipe.
À adapter à ton parcours : Mets en tête les pratiques que tu as prouvées dans tes expériences, puis une liste d’outils courte que tu pourrais défendre en entretien de conception.
La structure en résumé
- En-tête : Intitulé « Ingénieur machine learning » ou « ML engineer », années d’expérience, et ce que tu sais faire après l’entraînement : servir, réentraîner, surveiller.
- Expériences : Chaque poste avec le contexte de déploiement (nombre de modèles, sites ou utilisateurs, plateforme), puis des puces sur la latence, la reproductibilité, la surveillance et le déploiement progressif.
- Formation et certification : Master ou école d’ingénieurs en IA ou en informatique, avec le sujet de stage s’il touche à la production, puis une certification ML d’un fournisseur cloud si elle correspond à l’offre.
- Compétences : Les pratiques MLOps d’abord, puis les bibliothèques et l’outillage de production. Évite d’empiler toutes les architectures de modèles connues.
- Langues et intérêts : L’anglais est attendu pour lire la recherche et la documentation ; un intérêt comme la robotique ou la vision peut soutenir un projet de domaine.
Compétences et mots-clés ATS
- Mise en production de modèles : services d’inférence (FastAPI, ONNX Runtime, Triton), traitement par lots, GPU
- MLOps : pipelines d’entraînement (Vertex AI Pipelines, Kubeflow, Airflow), suivi d’expériences et registre de modèles (MLflow)
- Versionnement des données et des modèles (DVC), tests et packaging Python, conteneurs Docker et Kubernetes
- Surveillance en production : dérive des données et des prédictions (Evidently), métriques et alertes (Prometheus)
- Optimisation : quantification, distillation, export ONNX pour réduire la latence et le coût d’inférence
Les logiciels de tri (ATS) recherchent les termes exacts de l’offre. Pour un poste en ingénieur machine learning, intègre naturellement :
Les erreurs à éviter
- Décrire des modèles par leur architecture et leur score sans dire où ils tournent, pour qui, ni avec quelle latence.
- Écrire « MLOps » dans les compétences sans aucune puce qui le prouve : pipeline, registre, surveillance ou retour arrière.
- Négliger le volet logiciel : sans tests, sans revue de code et sans conteneurs, un recruteur classe le profil côté recherche.
- Ajouter une liste de modèles de langage à la mode sans projet derrière : mieux vaut un seul service en production, bien décrit.
Le conseil TechCV : Raconte un modèle comme un service : qui l’appelle, en combien de millisecondes il répond, comment on le réentraîne et comment on sait qu’il se dégrade. Si tu peux ajouter une puce sur un retour arrière ou un déploiement en mode fantôme, tu montres que tu as déjà vécu la production, ce que les entretiens cherchent à vérifier.
Questions fréquentes
Comment passer de data scientist à ingénieur machine learning sur un CV ?
Garde ton expérience de data scientist, mais réécris-la en mettant en avant ce qui touchait à la production : passage du notebook au traitement planifié, tests, registre de modèles. Ton poste suivant pourra alors porter l’intitulé visé sans rupture.
Faut-il citer les modèles de langage et l’IA générative ?
Seulement si tu as servi ou intégré un modèle de langage dans un produit, avec ses contraintes de coût et de latence. Une simple mention dans les compétences, sans projet, n’apporte rien sur un CV d’ingénieur ML.
Une thèse ou un master de recherche est-il un atout ?
Oui, s’il est présenté avec ce qu’il t’a appris d’utile en production (optimisation, compression, évaluation). Sans ce lien, le recruteur risque d’y voir un profil de chercheur plutôt qu’un ingénieur.
Pour aller plus loin
- Ingénieur machine learning, un poste qui dépasse les modèles
- IA générative sur un CV tech : signal fort ou mot à la mode ?
- Les questions qui reviennent en entretien de data scientist
Partez de ce CV ingénieur machine learning
Même structure, mêmes rubriques, prêtes à personnaliser. Export PDF d’une page.