CV de data scientist : le guide et un exemple analysé
Un recruteur qui lit un CV de data scientist cherche trois choses : des modèles qui ont servi une décision, une mesure rigoureuse de leur effet, et la preuve que tu sais les livrer sans dépendre d’une grande équipe. Une liste d’algorithmes ne répond à aucune des trois.
Cette page détaille ce que regardent les équipes data, la structure de CV qui fonctionne avec quelques années d’expérience, puis analyse section par section le modèle présenté ci-dessus, que tu peux reprendre et personnaliser dans le générateur.
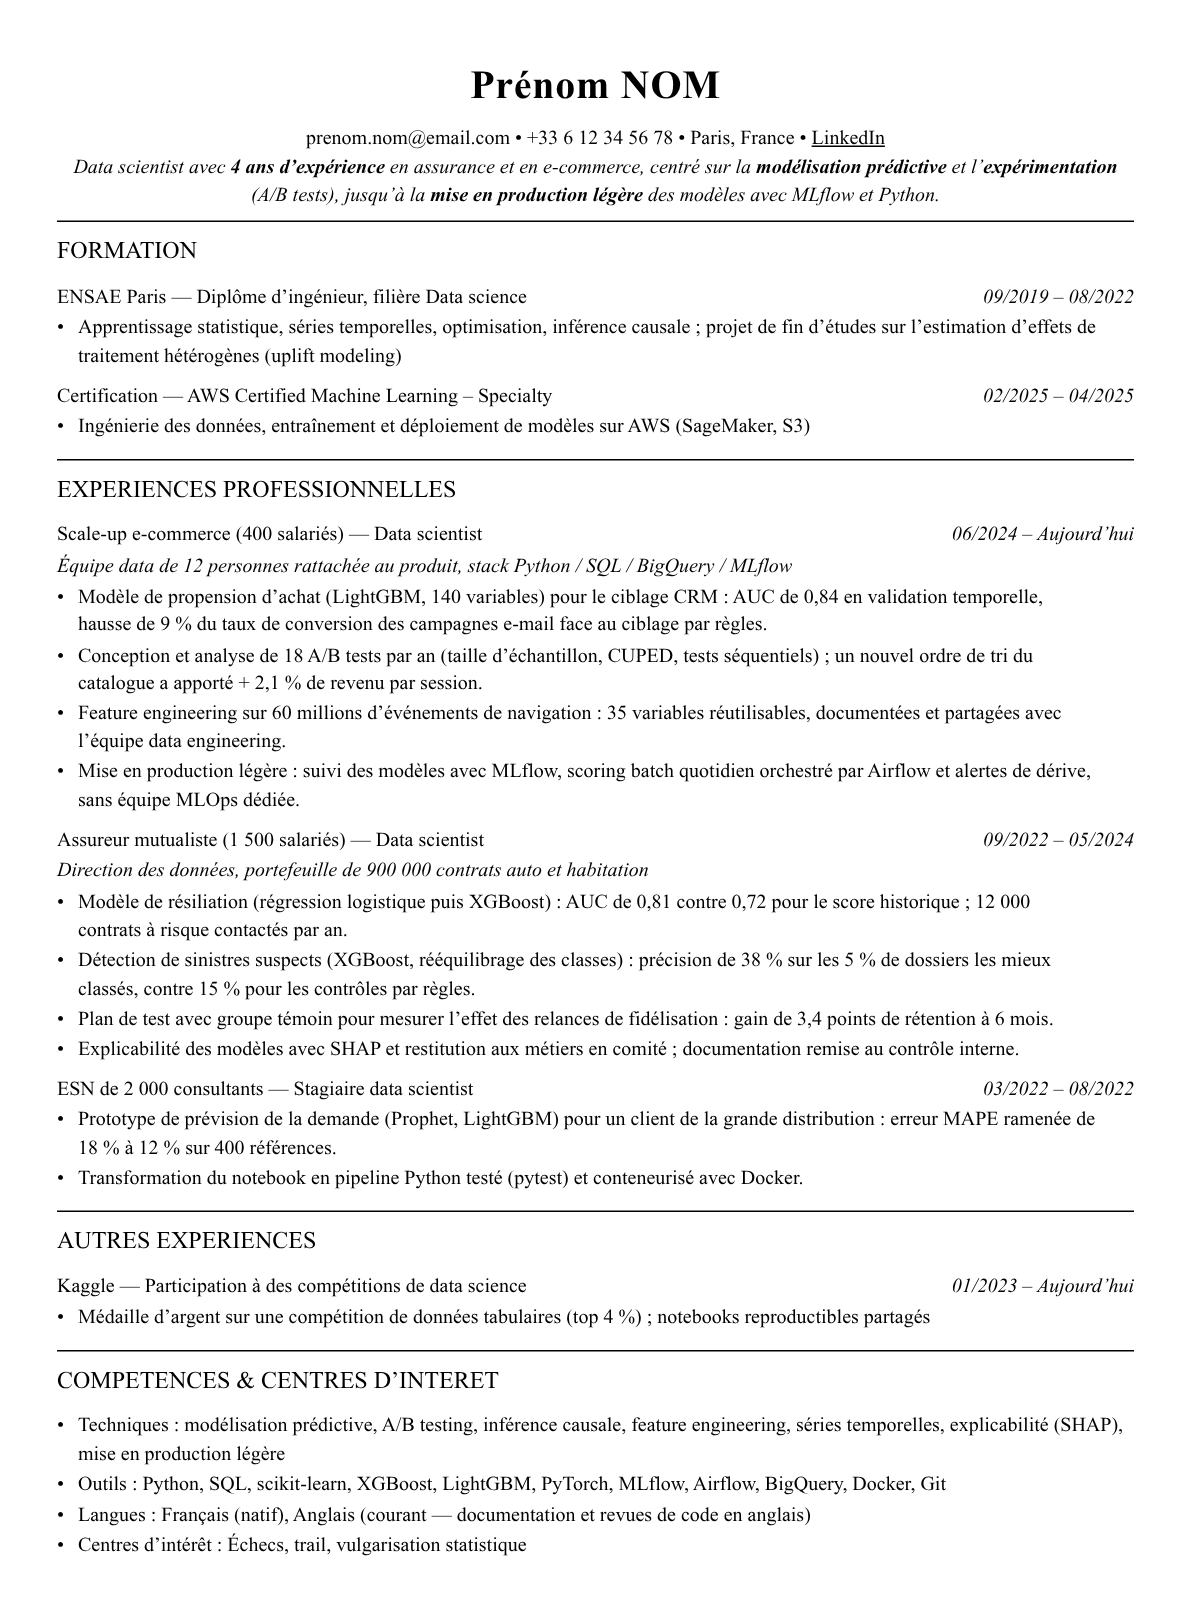
Ce CV est modifiable. Ouvre-le dans l’éditeur, remplace chaque ligne par ton parcours et exporte-le en PDF.
Ouvrir ce CV dans l’éditeurCe que les recruteurs attendent d’un CV data scientist
- Des modèles rattachés à un cas d’usage métier : churn, propension, fraude, prévision. Pour chacun, indique la métrique (AUC, précision, MAPE) et le point de comparaison, qu’il s’agisse d’une règle existante ou d’un modèle précédent.
- La maîtrise de l’expérimentation : A/B tests, taille d’échantillon, groupe témoin, lecture honnête d’un résultat. C’est ce qui sépare un profil data scientist d’un profil purement analytique.
- Une solide pratique du feature engineering et de SQL, car l’essentiel du temps se passe dans les données avant le modèle.
- La capacité à mettre un modèle en production légère : suivi avec MLflow, scoring planifié, surveillance de la dérive, code testé et versionné.
Le CV décortiqué, section par section
Chaque capture ci-dessous est extraite du CV data scientist présenté plus haut. Sous chacune : ce qui la rend efficace pour ce métier, et ce que tu dois y mettre de toi.
1. En-tête et accroche
Ancienneté, secteurs et centre de gravité en une phrase
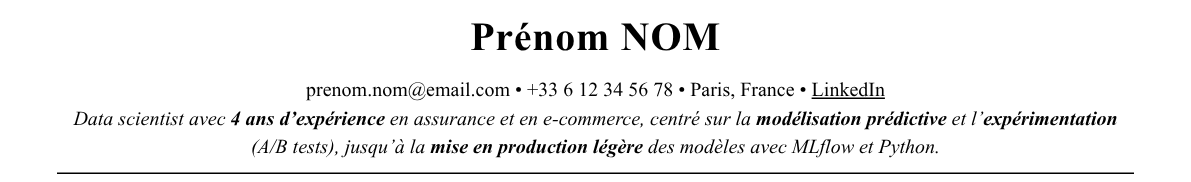
L’accroche donne l’expérience, les deux secteurs traversés et ce que le candidat fait le mieux : modéliser et expérimenter. Un recruteur sait en quelques secondes si le profil colle à son équipe.
Ce qui fonctionne
- « 4 ans d’expérience en assurance et en e-commerce » situe l’ancienneté et prouve une diversité de cas d’usage, du risque au marketing.
- « modélisation prédictive » et « expérimentation » nomment les deux piliers du poste, dans le vocabulaire exact des offres de data scientist.
- « mise en production légère des modèles avec MLflow et Python » annonce que le candidat livre ses modèles, sans prétendre être ML engineer.
À adapter à ton parcours : Reprends tes années d’expérience réelles, un ou deux secteurs et les deux compétences qui te définissent, puis garde une seule phrase.
2. Formation
Diplôme d’ingénieur et certification cloud ciblés
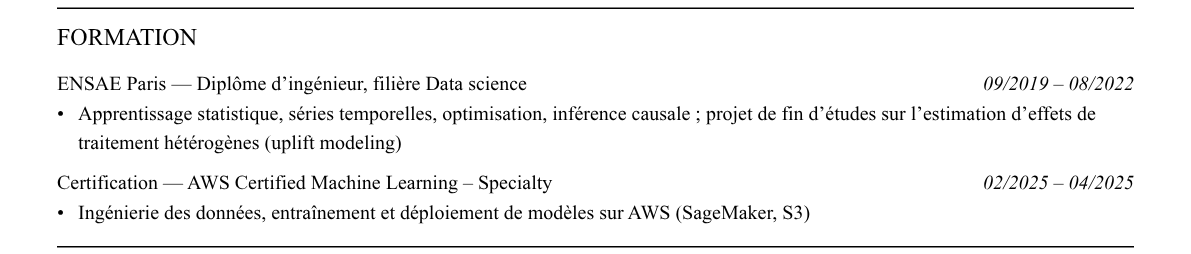
La formation ne sert plus qu’à vérifier la cohérence du parcours. Les deux lignes retenues montrent des bases statistiques solides, puis un complément cloud qui répond à la mise en production.
Ce qui fonctionne
- « Diplôme d’ingénieur, filière Data science » est suffisamment précis pour qu’un recruteur situe immédiatement le niveau.
- « inférence causale » et « estimation d’effets de traitement hétérogènes (uplift modeling) » annoncent la culture de l’expérimentation que les expériences vont démontrer.
- « SageMaker » dans la certification AWS relie la formation continue au déploiement de modèles, un besoin réel des équipes data.
À adapter à ton parcours : Ne garde que les enseignements utiles au poste visé, et cite une certification seulement si elle correspond à ce que tu veux faire dans l’équipe.
3. Expériences
Trois postes décrits du problème à l’effet mesuré
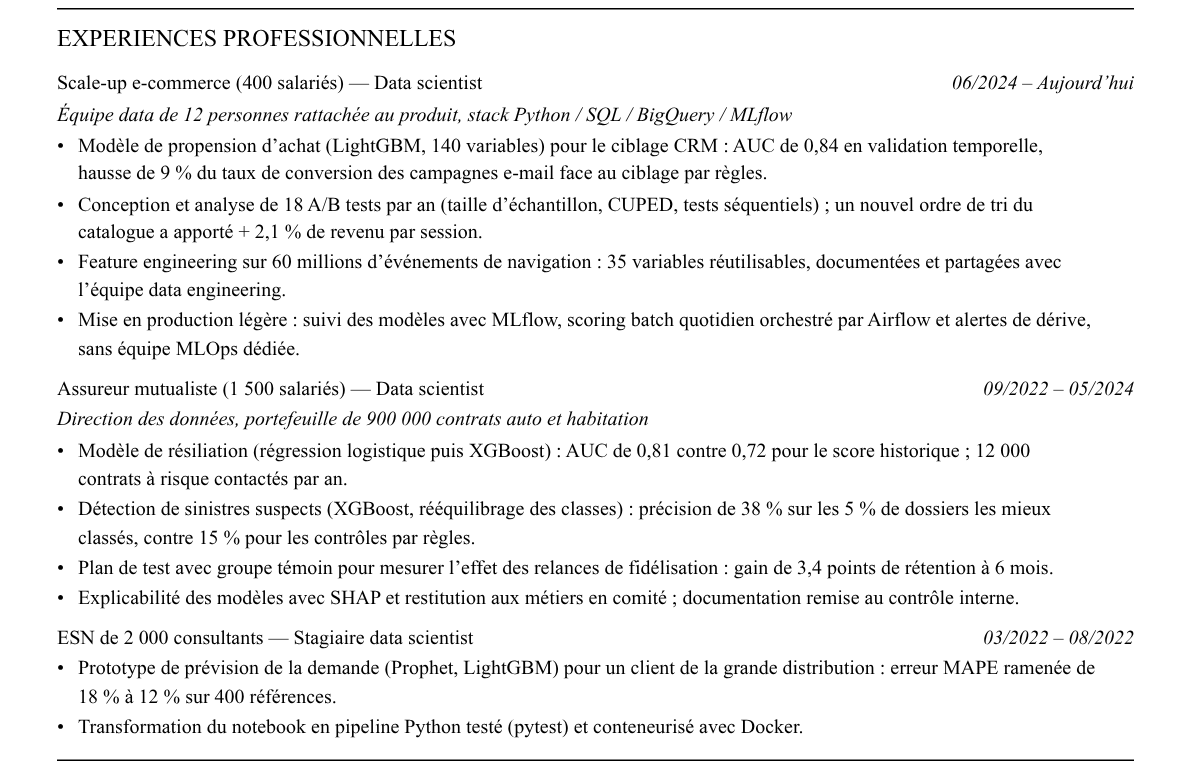
Chaque poste commence par la taille de l’entreprise et le contexte technique, puis enchaîne des puces qui suivent la chaîne complète : modèle, comparaison, effet, mise en production. Les chiffres restent d’un ordre de grandeur réaliste.
Ce qui fonctionne
- « AUC de 0,84 en validation temporelle » précise la méthode de validation, détail qui rassure un lecteur technique sur le sérieux de la mesure.
- « 18 A/B tests par an » donne un volume d’expérimentation concret, que la puce prolonge avec CUPED et les tests séquentiels.
- « AUC de 0,81 contre 0,72 pour le score historique » fournit la référence sans laquelle une métrique ne veut rien dire, et « 3,4 points de rétention à 6 mois » prolonge le résultat par un effet métier.
À adapter à ton parcours : Pour chaque poste, indique la taille de l’entreprise, la stack, puis pour chaque modèle sa métrique, sa référence de comparaison et ce qu’il a changé.
4. Compétences et centres d’intérêt
Techniques, outils et compétition qui servent le métier
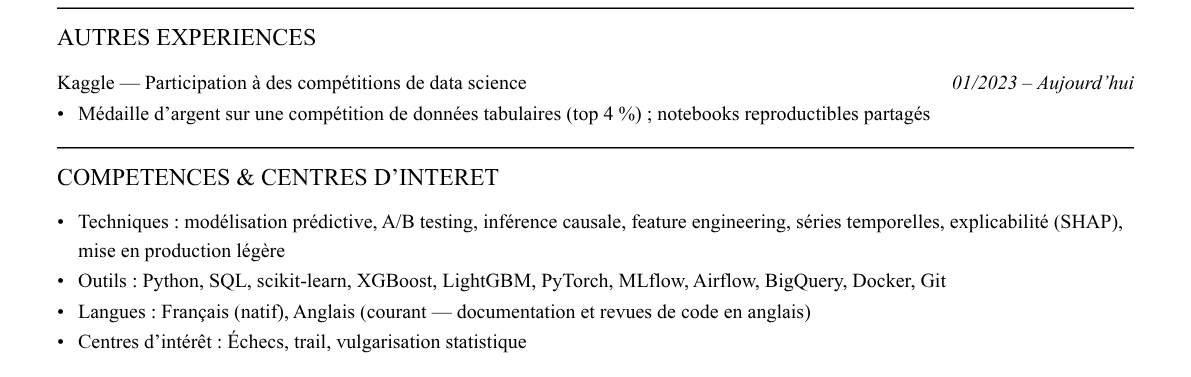
Le bloc final sépare les méthodes des outils, puis ajoute les langues et des intérêts choisis. La rubrique Kaggle complète l’expérience sans la remplacer.
Ce qui fonctionne
- « explicabilité (SHAP) » figure à côté de la modélisation : l’équipe voit que le candidat sait défendre un modèle devant les métiers.
- « Python, SQL, scikit-learn, XGBoost, LightGBM, PyTorch, MLflow, Airflow, BigQuery, Docker, Git » reste une liste courte d’outils réellement cités dans les expériences.
- « Médaille d’argent sur une compétition de données tabulaires (top 4 %) » donne un classement vérifiable, bien plus parlant qu’une simple mention de Kaggle.
À adapter à ton parcours : Ne liste que les outils que tu as réellement utilisés en conditions de production, rattache chaque langue à un usage, et chiffre toute compétition citée.
La structure en résumé
- En-tête : Nom, coordonnées, profil GitHub ou Kaggle si tu y publies du code propre, puis une accroche de deux lignes : années d’expérience, secteurs, et ton centre de gravité (modélisation, expérimentation, mise en production).
- Formation : École ou master avec la filière, puis les enseignements utiles au poste : apprentissage statistique, séries temporelles, inférence causale. Une certification cloud récente peut compléter, avec une ligne sur ce qu’elle couvre.
- Expériences : Par poste : taille de l’entreprise, contexte de l’équipe et stack, puis trois ou quatre puces qui suivent la chaîne complète : problème, modèle, mesure de l’effet, mise en production, avec des chiffres.
- Compétences : Sépare les techniques (modélisation prédictive, A/B testing, feature engineering, explicabilité) des outils (Python, SQL, scikit-learn, XGBoost, MLflow, Airflow), et donne un usage réel à chaque langue.
- Centres d’intérêt : Une ligne choisie pour nourrir l’entretien : compétitions de data science, projets open source, vulgarisation. Une compétition avec un classement précis vaut mieux qu’une mention vague.
Compétences et mots-clés ATS
- Modélisation prédictive supervisée : régression logistique, gradient boosting (XGBoost, LightGBM), validation croisée et validation temporelle
- Expérimentation : A/B testing, calcul de taille d’échantillon, CUPED, tests séquentiels, groupes témoins
- Feature engineering sur des volumes importants avec SQL et Python
- Explicabilité et documentation des modèles (SHAP), restitution aux équipes métier
- Mise en production légère : MLflow, scoring batch orchestré, alertes de dérive, Docker et tests
Les logiciels de tri (ATS) recherchent les termes exacts de l’offre. Pour un poste en data scientist, intègre naturellement :
Les erreurs à éviter
- Citer une AUC ou une précision sans point de comparaison : « AUC de 0,84 » ne dit rien tant que tu n’indiques pas le score ou la règle que ton modèle remplace.
- Lister vingt bibliothèques en vrac : les équipes veulent savoir lesquelles tu as utilisées en production, sur quel problème, et avec quel résultat.
- Parler de modèles sans dire ce qu’ils ont changé : sans effet mesuré sur un taux de conversion, une résiliation ou un coût, le travail reste un prototype.
- Présenter des projets de MOOC ou de notebooks comme de l’expérience : garde-les pour une ligne dédiée et mets en avant les modèles réellement utilisés par des équipes.
Le conseil TechCV : Pour chaque modèle, écris la phrase qui va du problème à la décision : « modèle de résiliation, AUC de 0,81 contre 0,72 pour le score historique, 12 000 contrats à risque contactés ». Le recruteur y lit à la fois le résultat, la référence et ce qui a été fait ensuite. Si tu as mesuré l’effet par un test avec groupe témoin, dis-le : c’est le détail qui distingue un modèle utile d’un modèle seulement performant.
Questions fréquentes
Faut-il indiquer ses métriques de modèle sur un CV de data scientist ?
Oui, mais toujours avec leur référence. Une AUC, une précision ou une erreur MAPE ne parle qu’à côté du score précédent ou de la règle métier que ton modèle a remplacée.
Comment montrer la mise en production quand on n’est pas ML engineer ?
Décris ce que tu as réellement livré : suivi des expériences avec MLflow, scoring planifié, alertes de dérive, code testé. Le terme de mise en production légère est honnête et très recherché dans les équipes de taille moyenne.
Les compétitions Kaggle ont-elles leur place sur le CV ?
Oui, en rubrique à part, avec un classement précis et des notebooks publics. Elles complètent l’expérience mais ne la remplacent pas : mets-les après tes postes, jamais avant.
Un GitHub est-il utile pour un data scientist ?
Oui, s’il montre du code propre et reproductible : environnement figé, tests, README clair. Un dépôt peu soigné dessert plus qu’il ne sert, alors ne le cite que s’il peut être lu en entretien.
Pour aller plus loin
- Les questions qui reviennent en entretien de data scientist
- Data analyst ou data scientist, deux métiers qu'on confond souvent
- Ingénieur machine learning, un poste qui dépasse les modèles
Partez de ce CV data scientist
Même structure, mêmes rubriques, prêtes à personnaliser. Export PDF d’une page.